
2026年8月7日,栖智·元力OPC社区科学技术协会携手AMD,组织社区成员走进 AMD ROCm Lab——一个围绕 GPU 计算与开源软件生态搭建的 AI 算力实验室。
AI 不只发生在模型和应用里
在大模型、Agent、多模态应用的背后,还有一层更底层的世界:GPU、AI 芯片、算力平台、开源软件生态。它们平时隐身在 API 调用和云服务账单后面,却实实在在决定了 AI 真正能跑多远、成本能压到多低、数据能不能留在自己手里。
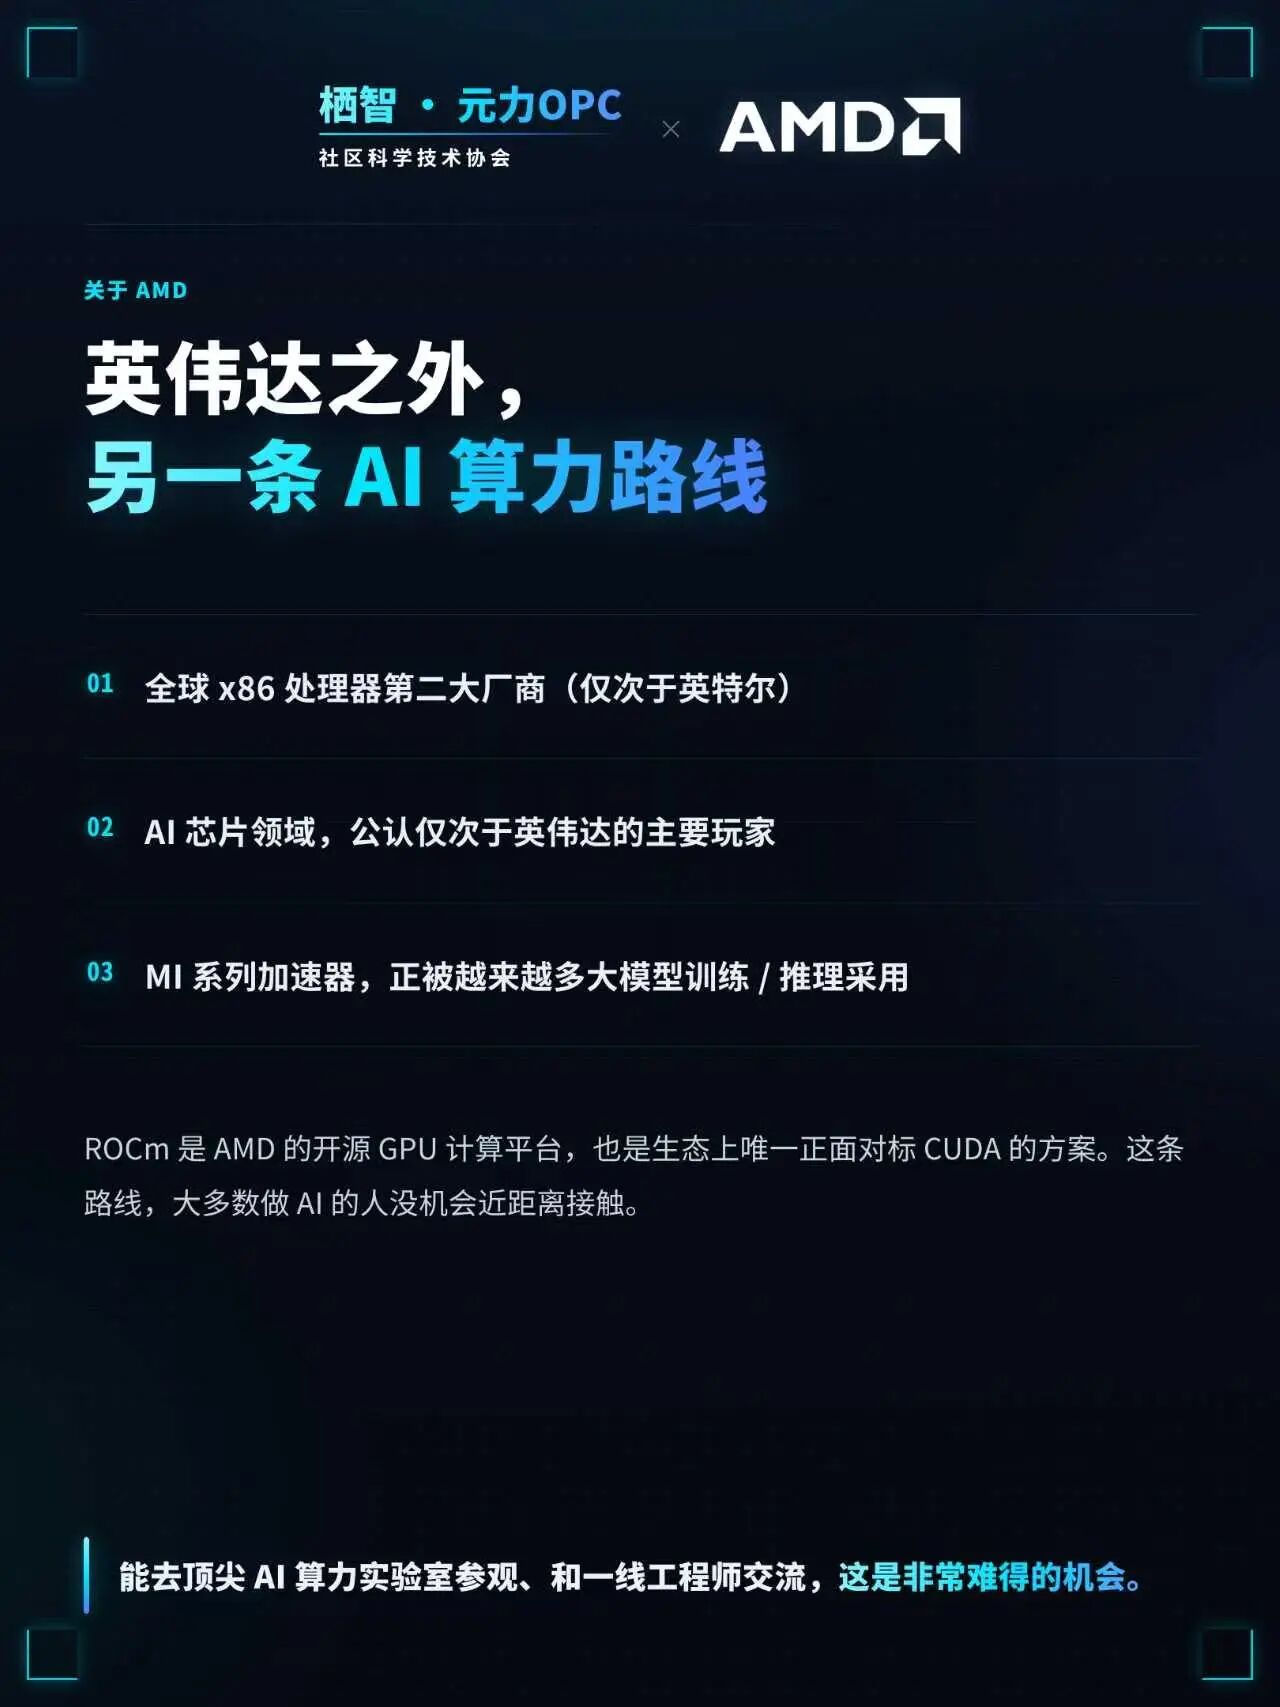
这次社区科协想带大家看看“AI 靠什么跑起来”。AMD,这家创立于1969年的公司,业务覆盖数据中心、嵌入式、游戏与 PC,同时具备 CPU 和 GPU 的大规模量产能力。而它主推的 ROCm,走的是一条开放路线——这恰恰是AI从业者们很关心的方向。
现场:从硬件矩阵到软件栈
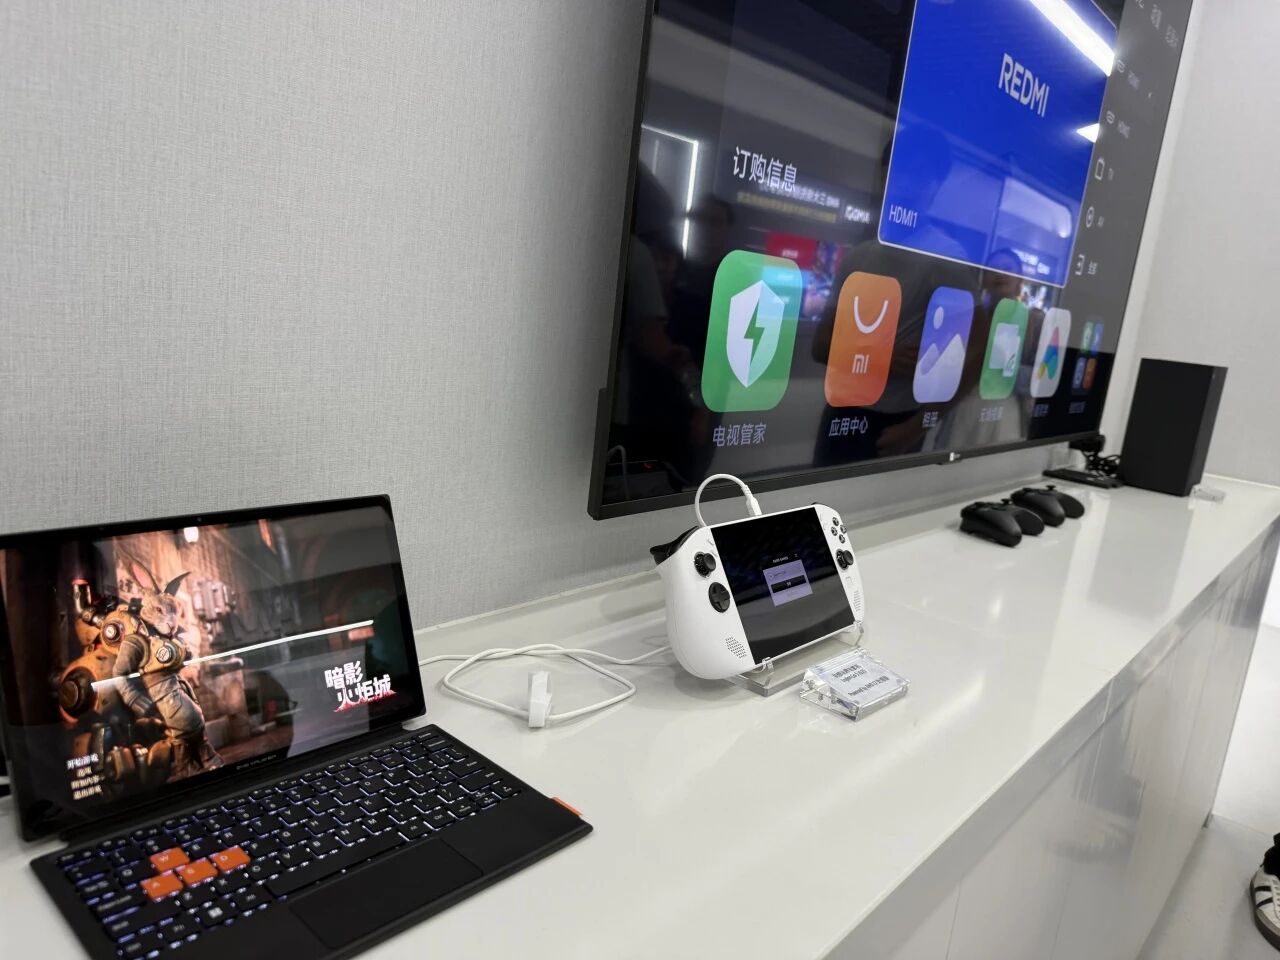
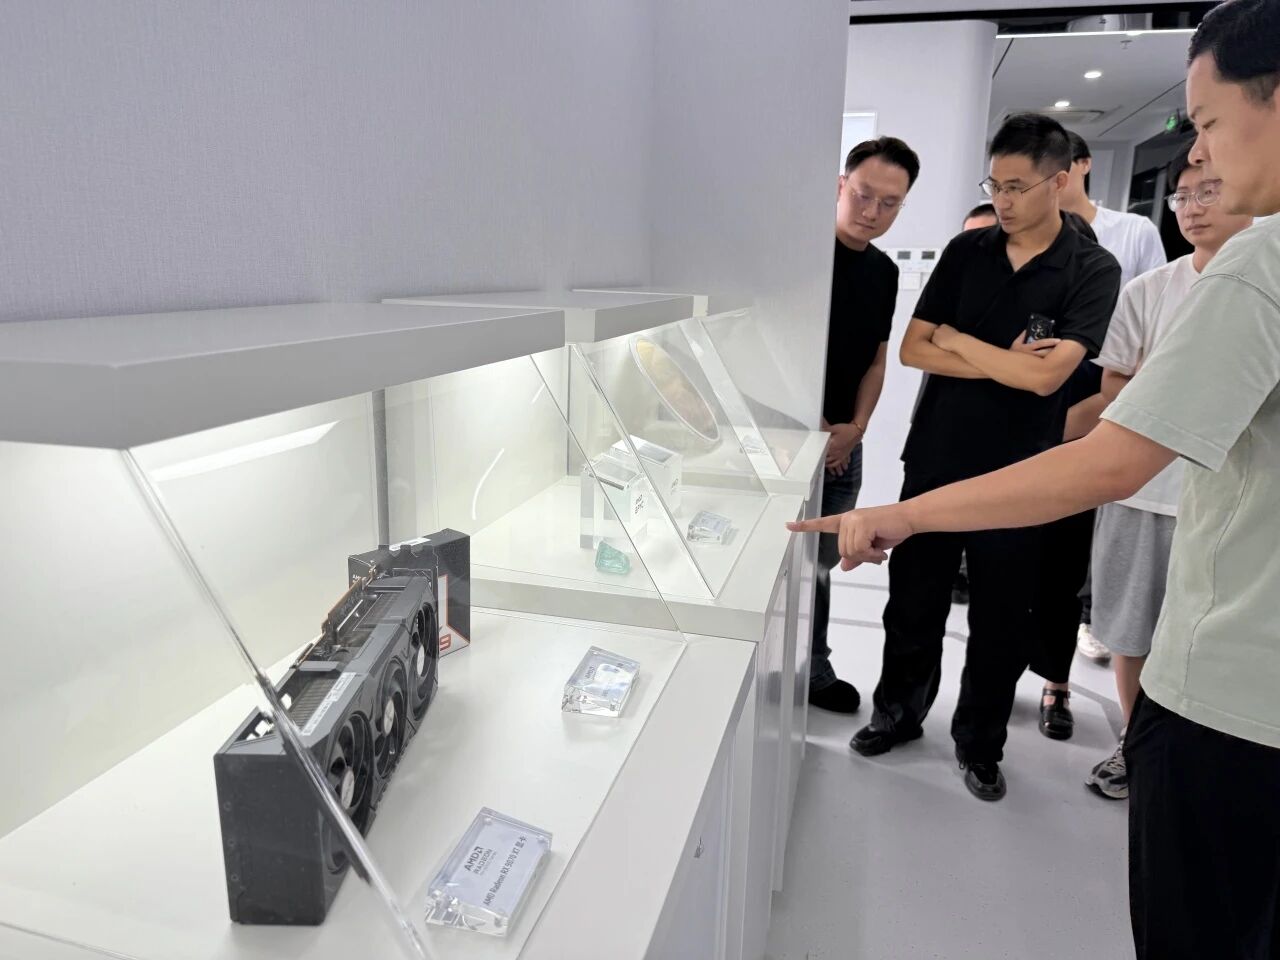
参访从实验室的硬件矩阵开始。AMD 的业务重心正在向数据中心和 AI 算力方案延展,对很多只在云端租过卡的开发者来说,近距离看到整机、加速卡和部署形态,是很直观的补课:原来“算力”不只是一个抽象的云上配置项。
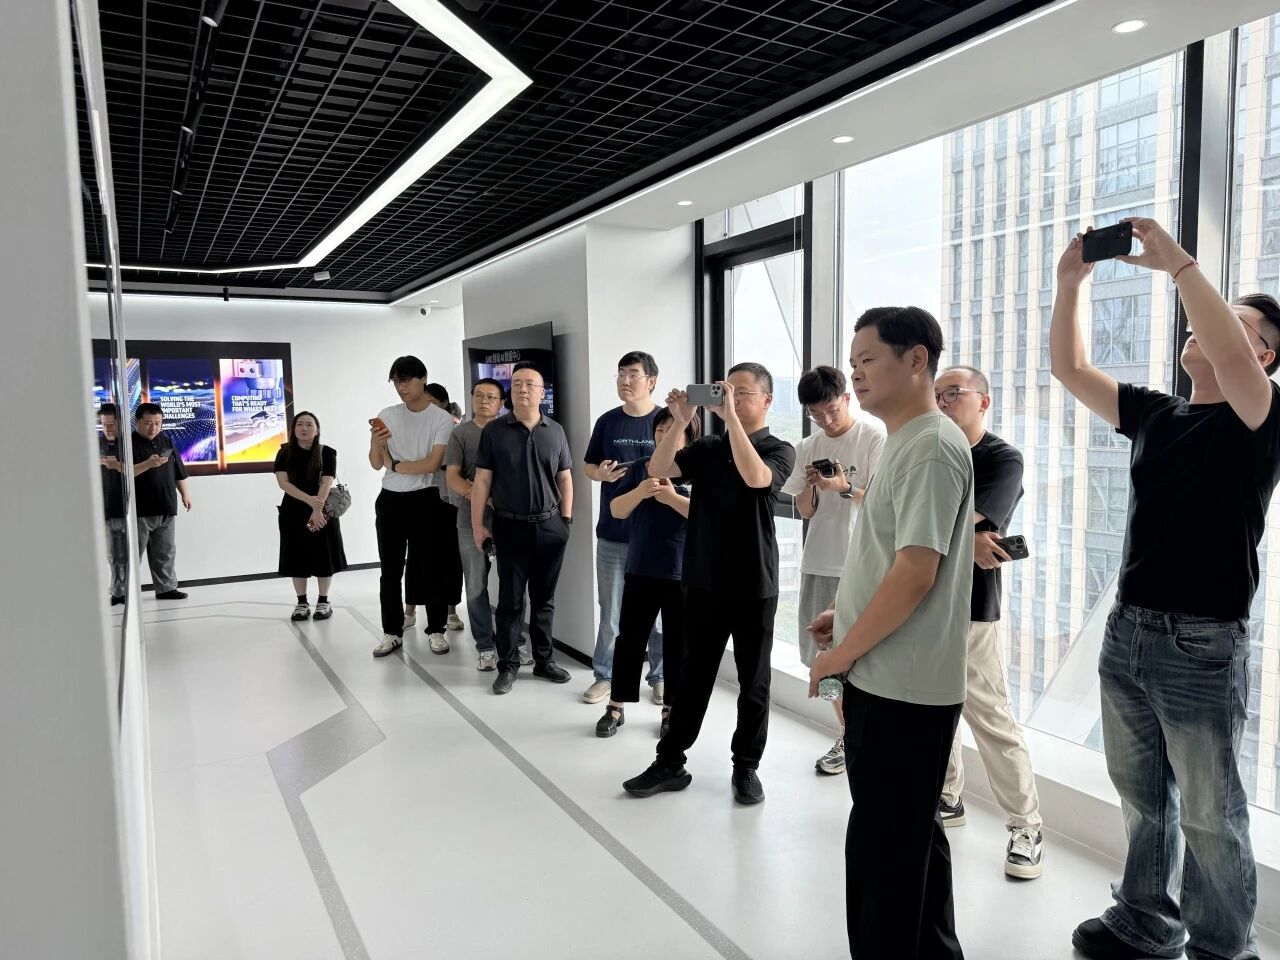
随后的技术分享聚焦 ROCm。这是一个面向 AI 和高性能计算的开放 GPU 软件栈,基于 MIT 协议开源,从底层驱动、计算库、开发工具一直覆盖到上层框架,适配 PyTorch、TensorFlow 等主流框架。现场的表述很直接:开源的目的,是降低生态绑定和迁移门槛,让开发者不必被锁死在单一平台上。
有成员追问了一个在场很多人都关心的问题:现有项目如果已经在 CUDA 上跑起来了,换栈的动力和代价分别是什么?讲解方没有回避,承认生态成熟度需要时间积累,但也给出了实际的路径——从测试资源、适配支持到工程协作,实验室愿意陪团队走过验证期。
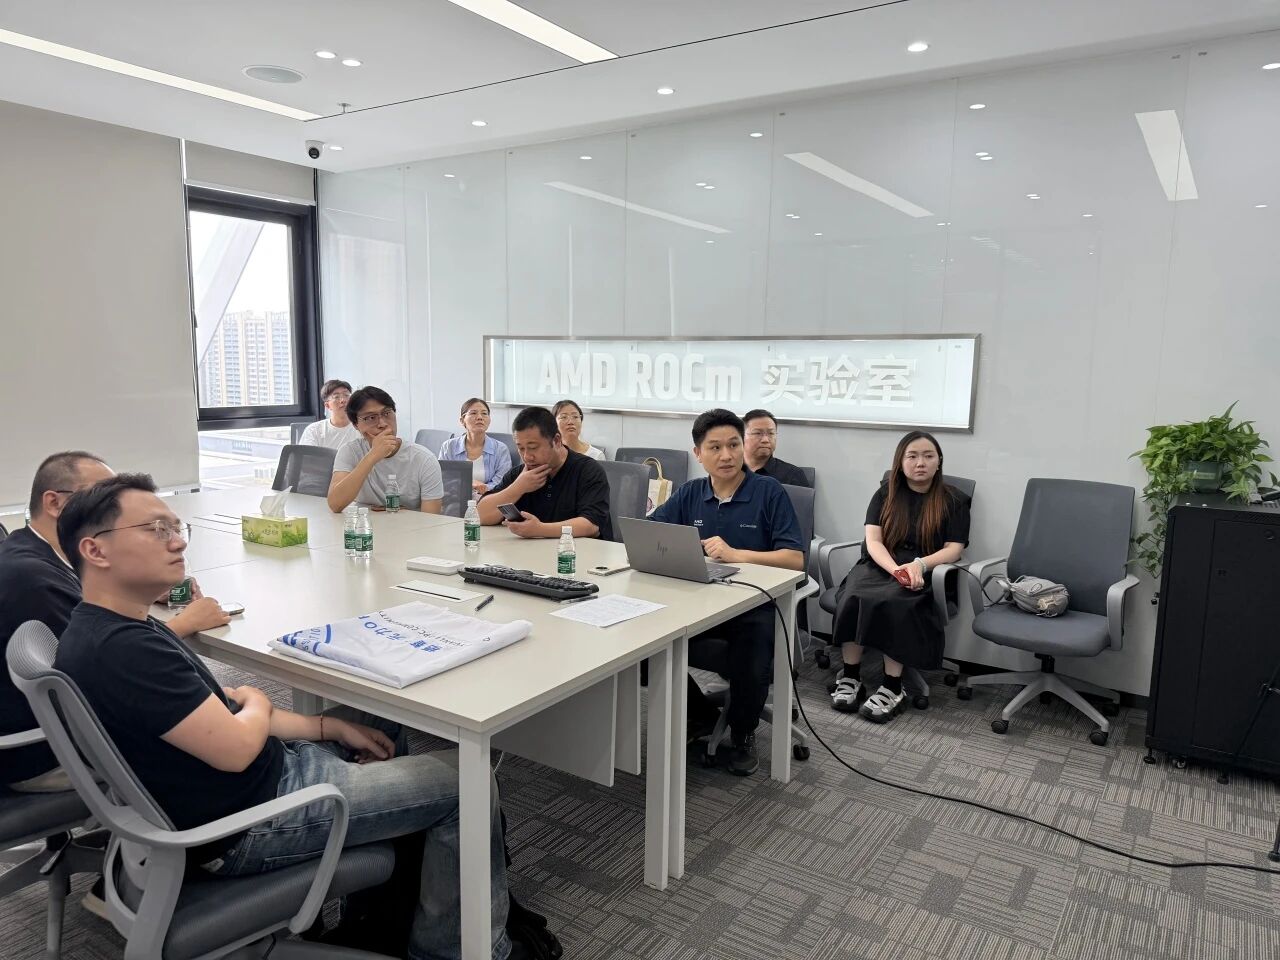
交流环节,成员的问题很具体:模型迁到 ROCm 上要改多少东西?本地部署一台带 GPU 的工作站,对中小团队是否划算?算力测试和适配支持怎么申请?讲解方也介绍了几个正在推进的落地方向,包括医疗健康、工业质检、教育科研,以及异构算力调度。
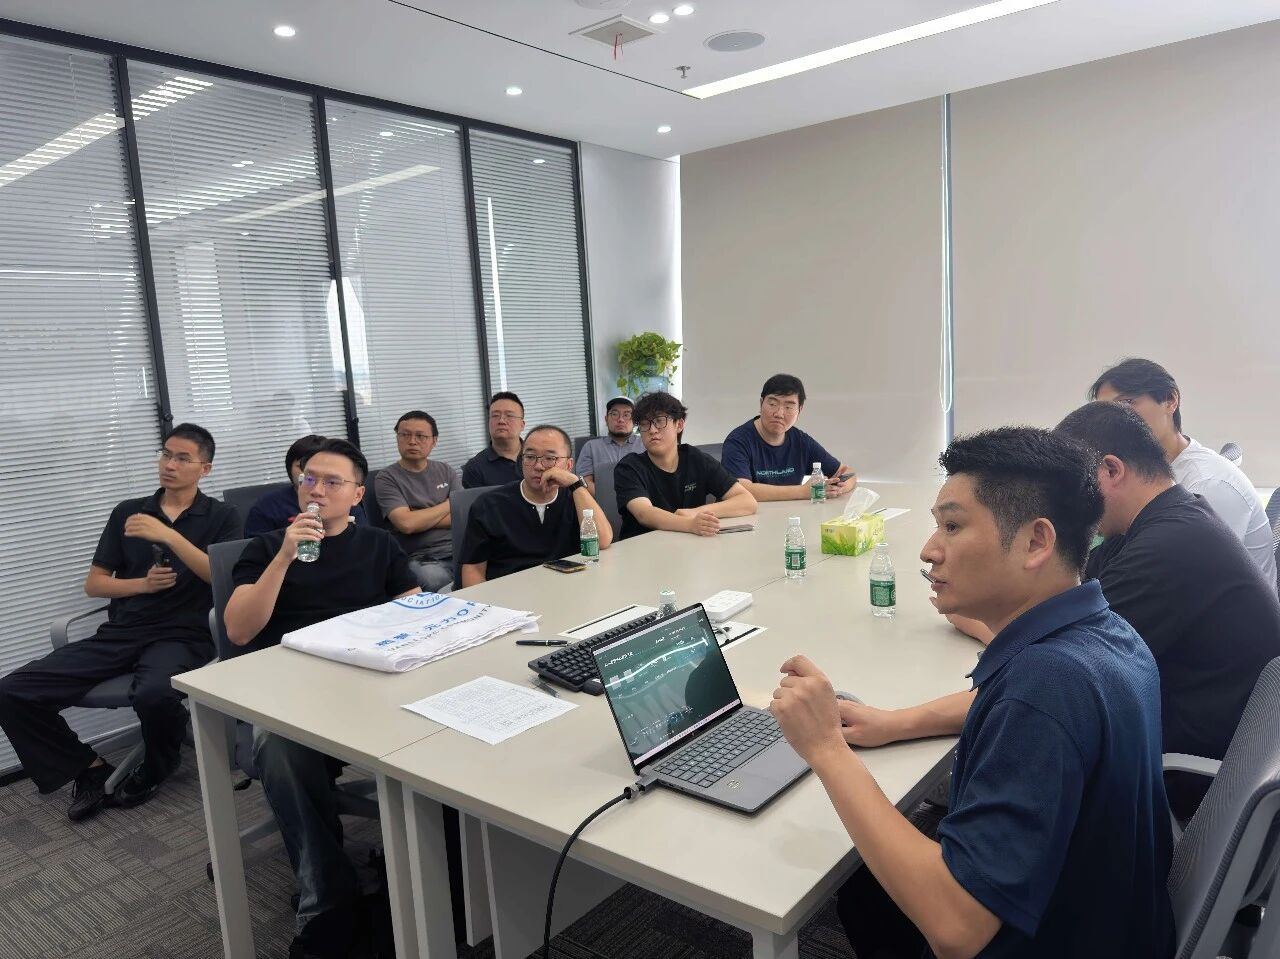
几轮问答里,成员有人关心旧代码迁过来后的兼容成本,有人直接带着自己的模型场景来,想现场判断是否适合迁移。
这些问题背后,是大家对“算力够用”的定义变了:参数表之外,更在意工程上能不能验证、成本上能不能持续。这大概也是 ROCm Lab 这类开放实验室存在的理由——它提供的不是一份参数表,而是一个可以把真实项目拿来跑一遍、把疑问摊开聊的环境。
半天,带回去的东西不太一样
对正在做项目的创业者来说,带走的多半是一本账。算力是商业模型的一部分,项目不只要比应用创意,还要算清算力成本、部署方式和数据安全。开发者们更在意的,是多出来的那条技术路线。多一个开放的软件栈,多一层多架构适配,选择权就留在自己手里。而参与开源社区本身,也是在积累可迁移的技术资产。
一上午的参访结束时,有成员说,最大的收获是“把很多听过但没见过的词对上了号”。也有人没急着走,留下来和实验室的同事互留了联系方式,约好过段时间把自己的模型带来实际测一轮。从看懂一块 GPU,到理解一个生态,这次参访打开的视角能走多远,要等这些后续的测试和交流来回答。
这也是栖智·元力OPC社区科学技术协会一直在做的事:把成员带到真实的产业现场,让创业者、开发者和行业伙伴面对面交流。接下来,“AI 场景开放日”还会继续,更多企业、实验室和真实场景,正在排期。